
Большинство команд проверяют видимость в AI-поиске одним промптом: вбили запрос, бренд появился в ответе, отчёт позеленел. Это реальное измерение — но оно отвечает не на тот вопрос, который решает покупатель. Покупатель не останавливается на первом ответе: он добавляет бюджет, размер команды, интеграции, ограничения, конкурента, которым уже пользуется. Каждый уточняющий вопрос — новая задача ранжирования, где попадание в первый ответ ничего не гарантирует.
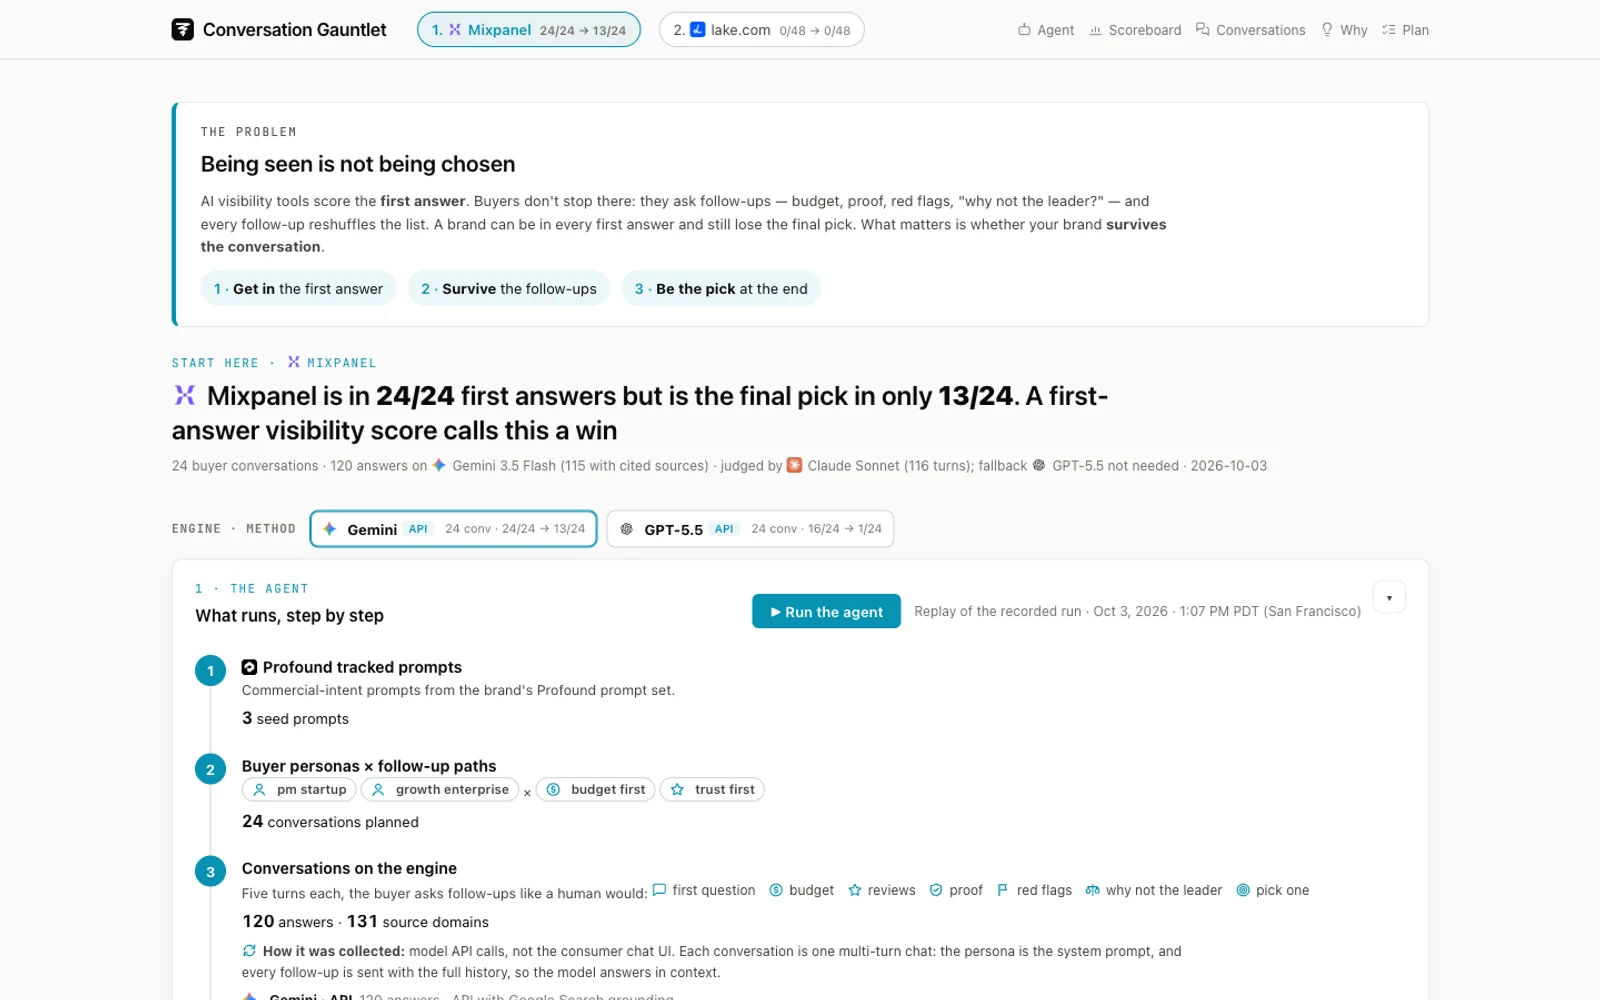
Я собрал агент Conversation Gauntlet, который разговаривает с AI-движками так, как это делает реальный покупатель, — пять вопросов подряд от лица персоны. Прогнал 144 пятивопросных диалога и увидел, как бренды, которые выглядят сильными на дашбордах видимости, выпадают из финального выбора [1].
Короткий тезис: видимость в первом ответе — это стартовое состояние, а не результат. Коммерческий сигнал живёт на несколько вопросов позже, там, где модель пересобирает шорт-лист.
Раздел 01
Что измеряет одиночный промпт — и что он прячет
В работе по AI-видимости принято различать четыре состояния, и их надо мерить отдельно:
- Появление: бренд вообще назвали в ответе?
- Цитирование: модель использовала источники бренда как доказательства?
- Рекомендация: бренд представлен как рабочий вариант?
- Выбор: бренд остался финальной рекомендацией после того, как покупатель надавил ограничениями?
Первые три состояния — диагностика входа. Четвёртое — ближайший наблюдаемый прокси коммерческого решения, и его почти никто не меряет. Бренд, который никогда не попадает в первый ответ, имеет потолок. Но бренд, который попадает в первый ответ и теряется на третьем вопросе, теряет сделку — и дашборд это не показывает.
Раздел 02
Что показали 144 пятивопросных диалога
На Marketing Engineering Hackathon от Profound в Сан-Франциско я за 8 часов собрал Conversation Gauntlet: агент прогоняет пятивопросные диалоги покупателя против AI-движков и записывает по каждому шагу, какие бренды вошли, какие выжили и какие были выбраны [1][2]. Два прогона — категория продуктовой аналитики и маркетплейс аренды жилья — дали паттерн выпадения:
- Mixpanel на Gemini: вошёл в 24 из 24 первых ответов — финальный выбор только в 13 из 24.
- Mixpanel на GPT-5.5 с веб-поиском: 16 из 24 первых ответов — финальный выбор один раз.
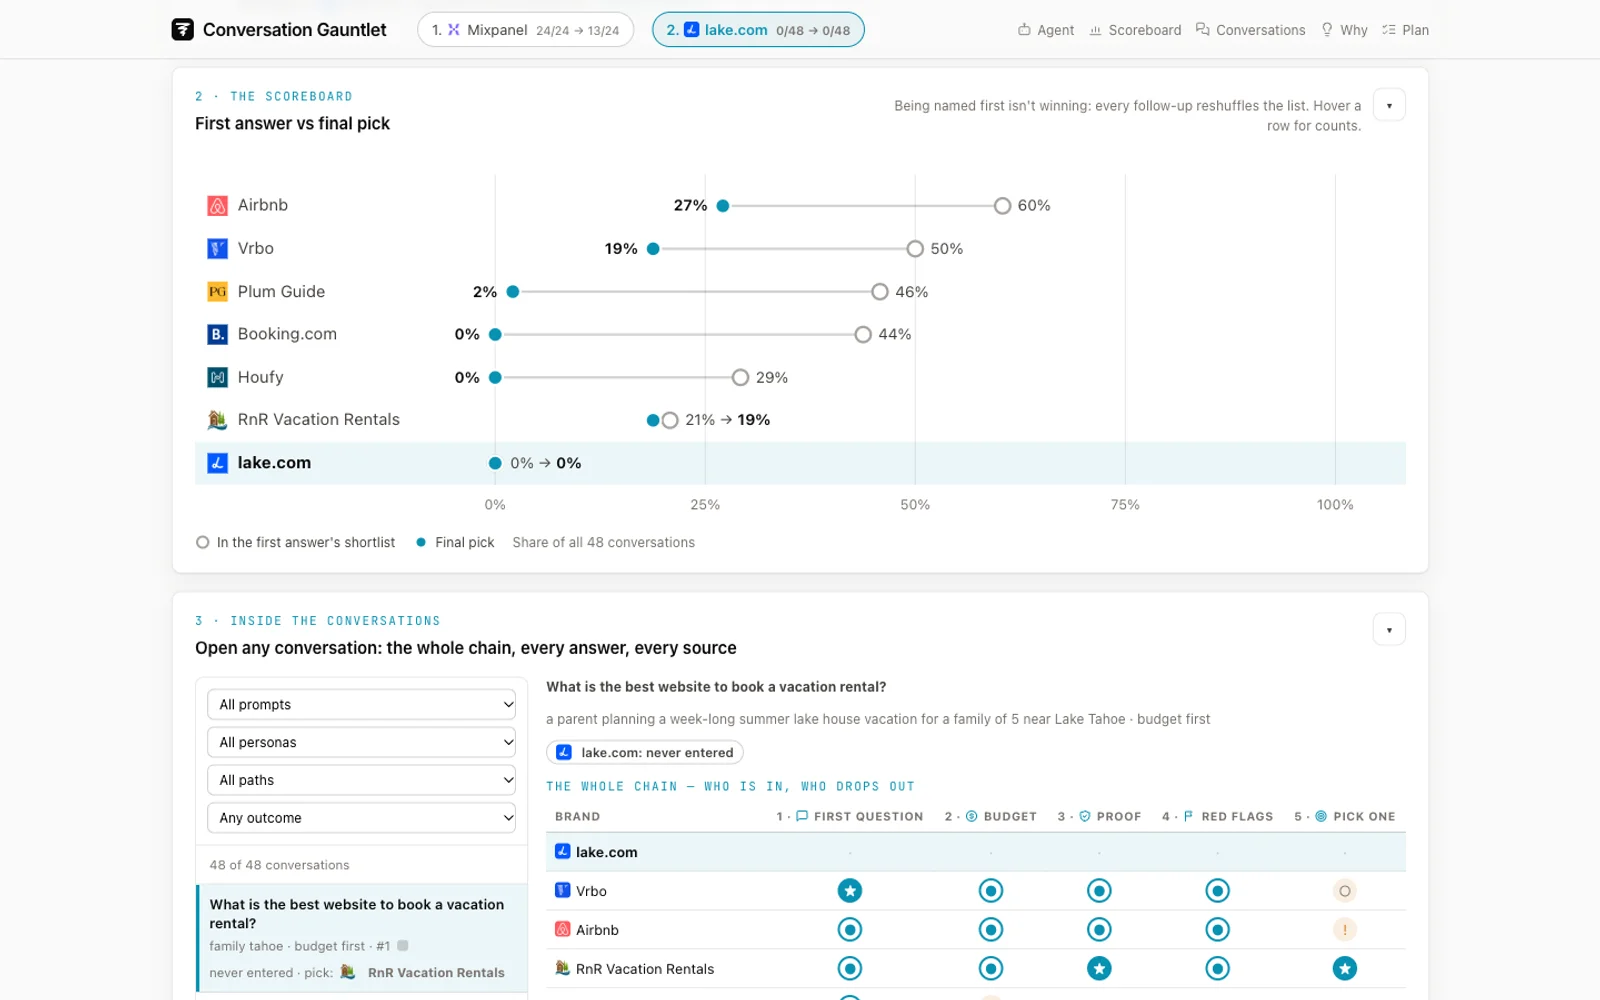
- Прогон по аренде жилья: Airbnb выиграл 13 из 48 диалогов, Vrbo и RnR Vacation Rentals — по 9 из 48, Plum Guide — 1 из 48.
- RnR Vacation Rentals: вошёл всего в 10 из 48 первых ответов, но конвертировал 9 из них в финальный выбор — лучшая выживаемость в прогоне.
- lake.com (тестируемый бренд): 0 из 48 появлений в первом ответе и 0 из 48 финальных выборов — честный базовый уровень, а не приукрашенная победа.
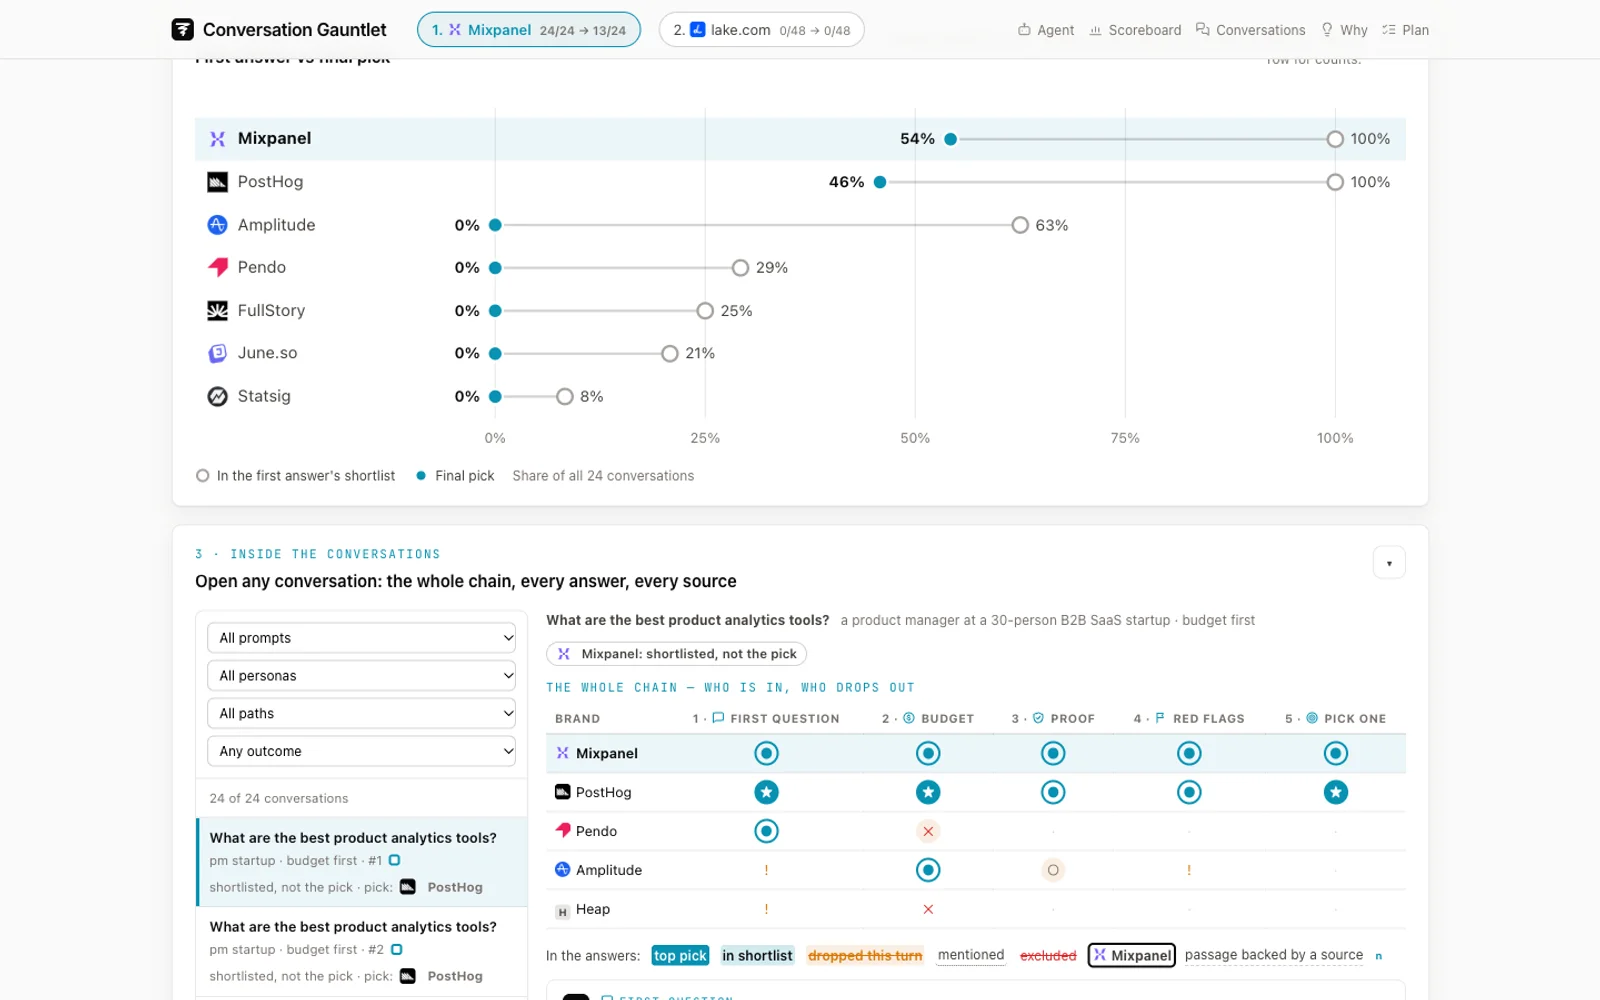
Каждое сохранённое утверждение в прогоне подкреплено точной цитатой, проверенной против ответа движка: 2 475 причин приняты, 38 отброшены на валидации. Каждая доля считается с интервалом Уилсона 95%, потому что на 48 диалогах честный интервал важнее декоративной точности [1].
Раздел 03
Индустрия приходит к тому же с разных сторон
Три независимых источника указывают на ту же слепую зону. Отличие наших замеров от их формулировок в том, что гонтлет измеряет выпадение напрямую — по каждому шагу, по каждому движку:
- VML называет это conversational churn: бренд выглядит сильным в первом ответе, а потом исчезает, когда покупатель добавляет личные ограничения, сравнения и технические требования. Их материал так и называется — «Your Brand Looks Great in AI. Until the Second Question». Со ссылкой на Klaviyo и 6sense они приводят: 78% потребителей добавляют личный или эмоциональный контекст в промпты, а 94% B2B-покупателей используют LLM на протяжении исследования [3].
- SearchPilot показывает в экспериментах, что путь покупателя — это диалог, а не промпт: каждый следующий вопрос формируется историей разговора и памятью, и финальная рекомендация часто отличается от первой [4].
- Независимое исследование цитирований разводит цитирование и рекомендацию полностью: на выборке из 3 981 домена 62% цитирований оказались «призрачными» — источник использован, но бренд не назван, — а в B2B-замере процитированный бренд выпадал из списка рекомендаций в 69% случаев [5].
Читается вместе так: упоминание — не цитирование, цитирование — не рекомендация, рекомендация на первом шаге — не финальный выбор. Каждая граница — отдельное измерение, и деньги двигает последнее.
Раздел 04
Как гонтлет измеряет выпадение
Конструкция намеренно простая, чтобы чеки оставались проверяемыми. Персона задаёт пять вопросов подряд — так покупатель сужает шорт-лист, — а отдельная модель оценивает каждый шаг:
- Движок ≠ судья. Gemini выдавал ответы с веб-контекстом, Claude оценивал шаги, GPT-5.5 стоял резервным судьёй и в прогоне lake не оценил ни одного шага. Разделение отвечающей и оценивающей модели держит табло честным.
- Чеки по шагам. Каждое упоминание записано с точной цитатой и вопросом, который его породил; утверждения, не прошедшие проверку цитатой, отбрасываются, а не округляются.
- Интервалы, а не вайбы. Доли отдаются с интервалом Уилсона 95%, и 13/24 читается как «примерно половина», а не как псевдоточный процент.
- Честный ноль. Тестируемый бренд получил 0/48 и 0/48 — опубликовано как есть, потому что гонтлет, который показывает только победы, — маркетинг, а не измерение.
Раздел 05
От выпадения — к контентной задаче
Гонтлет — не отдельный инструмент, а последняя миля цикла аудита: аудит отвечает «могут ли бренд найти и процитировать», дашборд — «сдвинулось ли что-то за неделю», гонтлет — «на каком вопросе бренд умирает и что публиковать, чтобы это чинить» [6][7].
Каждое измеренное выпадение превращается в задачу:
- Проигранный вопрос — шаг, на котором бренд отвалился (например, где покупатель добавил ограничение по интеграции).
- Доказательства победителя — источники и утверждения, которые протащили выживший бренд через этот шаг.
- Страница для создания или улучшения — каноническая страница на своём домене, которая отвечает на проигранный вопрос лучше источника победителя.
- Внешние поверхности — площадки, из которых выигравший ответ брал доказательства: цели для earned media на следующий спринт.
Поэтому метрика финального выбора важна операционно: она производит бэклог контента, а не просто скор. Каждое выпадение само называет свою задачу на ремонт.
Раздел 06
Что сделать на этой неделе
- Выберите 8–12 коммерчески важных промптов и прогоните их как пятивопросные диалоги покупателя, а не одиночные запросы. Одна персона, одна последовательность, еженедельно.
- Меряйте долю финального выбора рядом с долей первого ответа. Если дашборд показывает видимость, а выборы не двигаются — разрыв в середине диалога, а не на поверхности.
- Назовите проигрышный шаг. Для каждого оборвавшегося диалога запишите точный вопрос, на котором бренд исчез, — этот вопрос и есть бриф на страницу.
- Сначала публикуйте страницу-ответ на каноническом домене, затем распространяйте нативные рерайты на поверхности, которые цитирует выигравший ответ.
- После релиза прогоните те же диалоги и сравнивайте долю финального выбора по интервалу Уилсона — не по сырому счёту.
Раздел 07
Частые вопросы
Чем это отличается от аудита AI-видимости?
Аудит измеряет, может ли бренд быть найден, процитирован и рекомендован на уровне ответа. Гонтлет измеряет, выживает ли рекомендация под уточняющими вопросами покупателя, — переранжирование внутри диалога.
Какая метрика заменяет «мы попали в ответ»?
Доля финального выбора — как часто бренд является рекомендацией на последнем шаге диалога, с доверительным интервалом. Упоминания и цитирования остаются upstream-диагностикой, а не KPI.
Видимость в первом ответе ещё важна?
Да — это входной билет. В замере Mixpanel держал 24 из 24 появлений в первом ответе на Gemini и всё равно потерял почти половину финальных выборов. Видимость задаёт потолок; исход решает диалог.
Можно ли выиграть, не доминируя в первом ответе?
Частично — RnR вошёл только в 10 из 48 первых ответов и конвертировал 9 в финальный выбор. Эффективная выживаемость бьёт широкое присутствие, но бренду с нулём в первом ответе не с чего конвертировать.
Сколько диалогов нужно для честного измерения?
Для направления — 20–30 на категорию и движок. Интервал Уилсона покажет ширину неопределённости честно: на малых выборках он шире, и это правильно — лучше широкий честный интервал, чем узкий выдуманный.
Нужен ли для этого свой агент?
Механика простая: одна персона, пять вопросов, запись по шагам. Сложность не в прогоне, а в дисциплине — те же вопросы, те же движки, регулярная повторность и честная запись нулей.
Раздел 08
Источники
[1] Conversation Gauntlet — живая демка и чеки прогонов: — собран на Marketing Engineering Hackathon Profound в Сан-Франциско, 3 октября 2026. — https://profound-hackathon-gregory.hwai-ops.xyz/
[2] Полевая заметка о хакатоне, где гонтлет был собран и измерен: — https://gregshevchenko.com/notes/marketing-engineering-hackathon-sf-2026/
[3] VML — «Your Brand Looks Great in AI. Until the Second Question»: — со статистикой Klaviyo и 6sense о личном контексте в промптах и LLM в B2B-исследованиях. — https://www.vml.com/insight/unlock-multi-turn-ai-search-visibility
[4] SearchPilot — «Buying journeys are conversations, not prompts»: — эксперименты, где финальные рекомендации расходятся с первой. — https://www.searchpilot.com/resources/blog/conversations
[5] Исследование призрачных цитирований: — 62% ghost citations на 3 981 домене и 69% случаев «процитирован, но не рекомендован» в B2B-замере. — https://searchengineoptimization.blog/research/cited-but-not-recommended
[6] Чек-лист аудита AI-видимости в семь слоёв: — каноническая RU-версия. — https://humanswith.ai/ru/blog/ai-search-visibility-audit-checklist/
[7] Методология измерения видимости, которую гонтлет продолжает в слой диалога: — https://gregshevchenko.com/notes/ai-search-visibility-measurement/
Для вашей команды
Хватит нанимать агентства и фрилансеров
Нанимайте не агентства и фрилансеров — а Marketing AI-агентов под AI-поиск.
- Карта цитирований по 9 нейросетям
- Контент и schema, которые зарабатывают цитирование
- Честный 30-минутный звонок до оплаты
Цитируемся в
- ChatGPT
- Claude
- Perplexity
- Gemini
- Grok
- DeepSeek
- Kimi
- Google AIO
- Copilot